OpenAI 发布 GPT-6 Astra:从模型能力跃迁到端到端工作执行
OpenAI 正式发布 GPT-6 Astra,并将它定位为目前能力最强的模型,重点提升了计算机操作、浏览、软件工程、网络安全、科学研究和专业工作能力。
与只回答问题或生成文本的模型相比,Astra 更强调一件事:在获得适当工具和权限后,能否理解目标、操作软件、检查结果,并完成一段较长的端到端工作流程。这也是理解此次发布的关键 。OpenAI 展示的不只是模型在单项问答测试中的得分, 而是它在真实数字工作环境中持续执行任务的能力。
Astra 的主要变化是什么
OpenAI 对 Astra 的介绍可以归纳为四个方向 :
第一 ,计算机操作能力进一步增强。Astra 可以在浏览器 、电子表格 、文档编辑器 、CRM 和专业软件中执行多步骤任务 ,例如填写表单 、整理客户记录 、完成在线研究、制作分析材料和检查网页功能。
第二 ,模型更擅长把专业判断转化为可直接使用的交付物 。OpenAI 特别强调了文档、演示文稿 、电子表格 、网站和应用的完成质量 ,包括遵循已有模板 、保持叙事结构 、减少无关内容 ,以及根据上下文补足常规细节 。
第三 ,Astra 在长任务中的上下文保持能力得到强化 。在 Codex 中,它可以跨上下文窗口保存和检索工作信息 ,减少多次压缩上下文后遗漏早期要求 、失败原因和测试结果的情况 。
第四 ,OpenAI 将 “是否遵守用户授权范围”作为这次发布的重要指标。Astra 不仅要把任务做完,还需要避免在目标不可能完成或信息不足时擅自扩大权限、绕过限制或采取破坏性操作。
官方测试结果概览
以下数据来自 OpenAI 发布页面。对比对象主要是 GPT-5.6 Sol。除特别说明外 ,分数越高越好 。
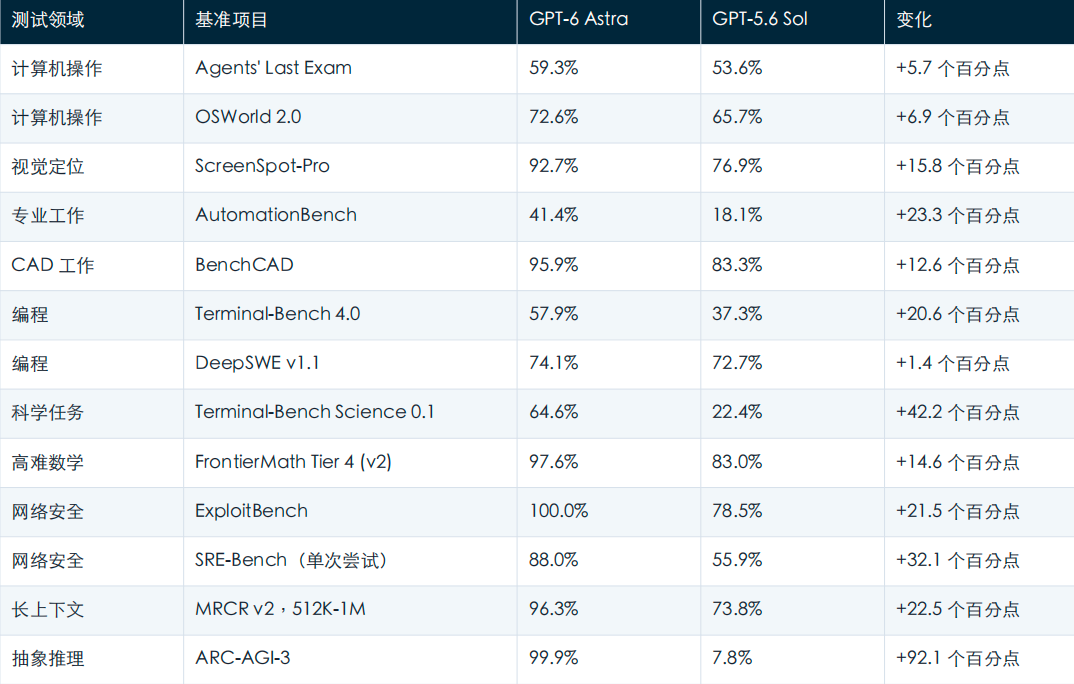
这些数据反映出 ,Astra 的提升并不平均分布在所有项目上。部分传统编程测试的增幅相对有限,而科学任务 、计算机工作流 、长上下文和抽象推理项目出现了更明显的跃升。
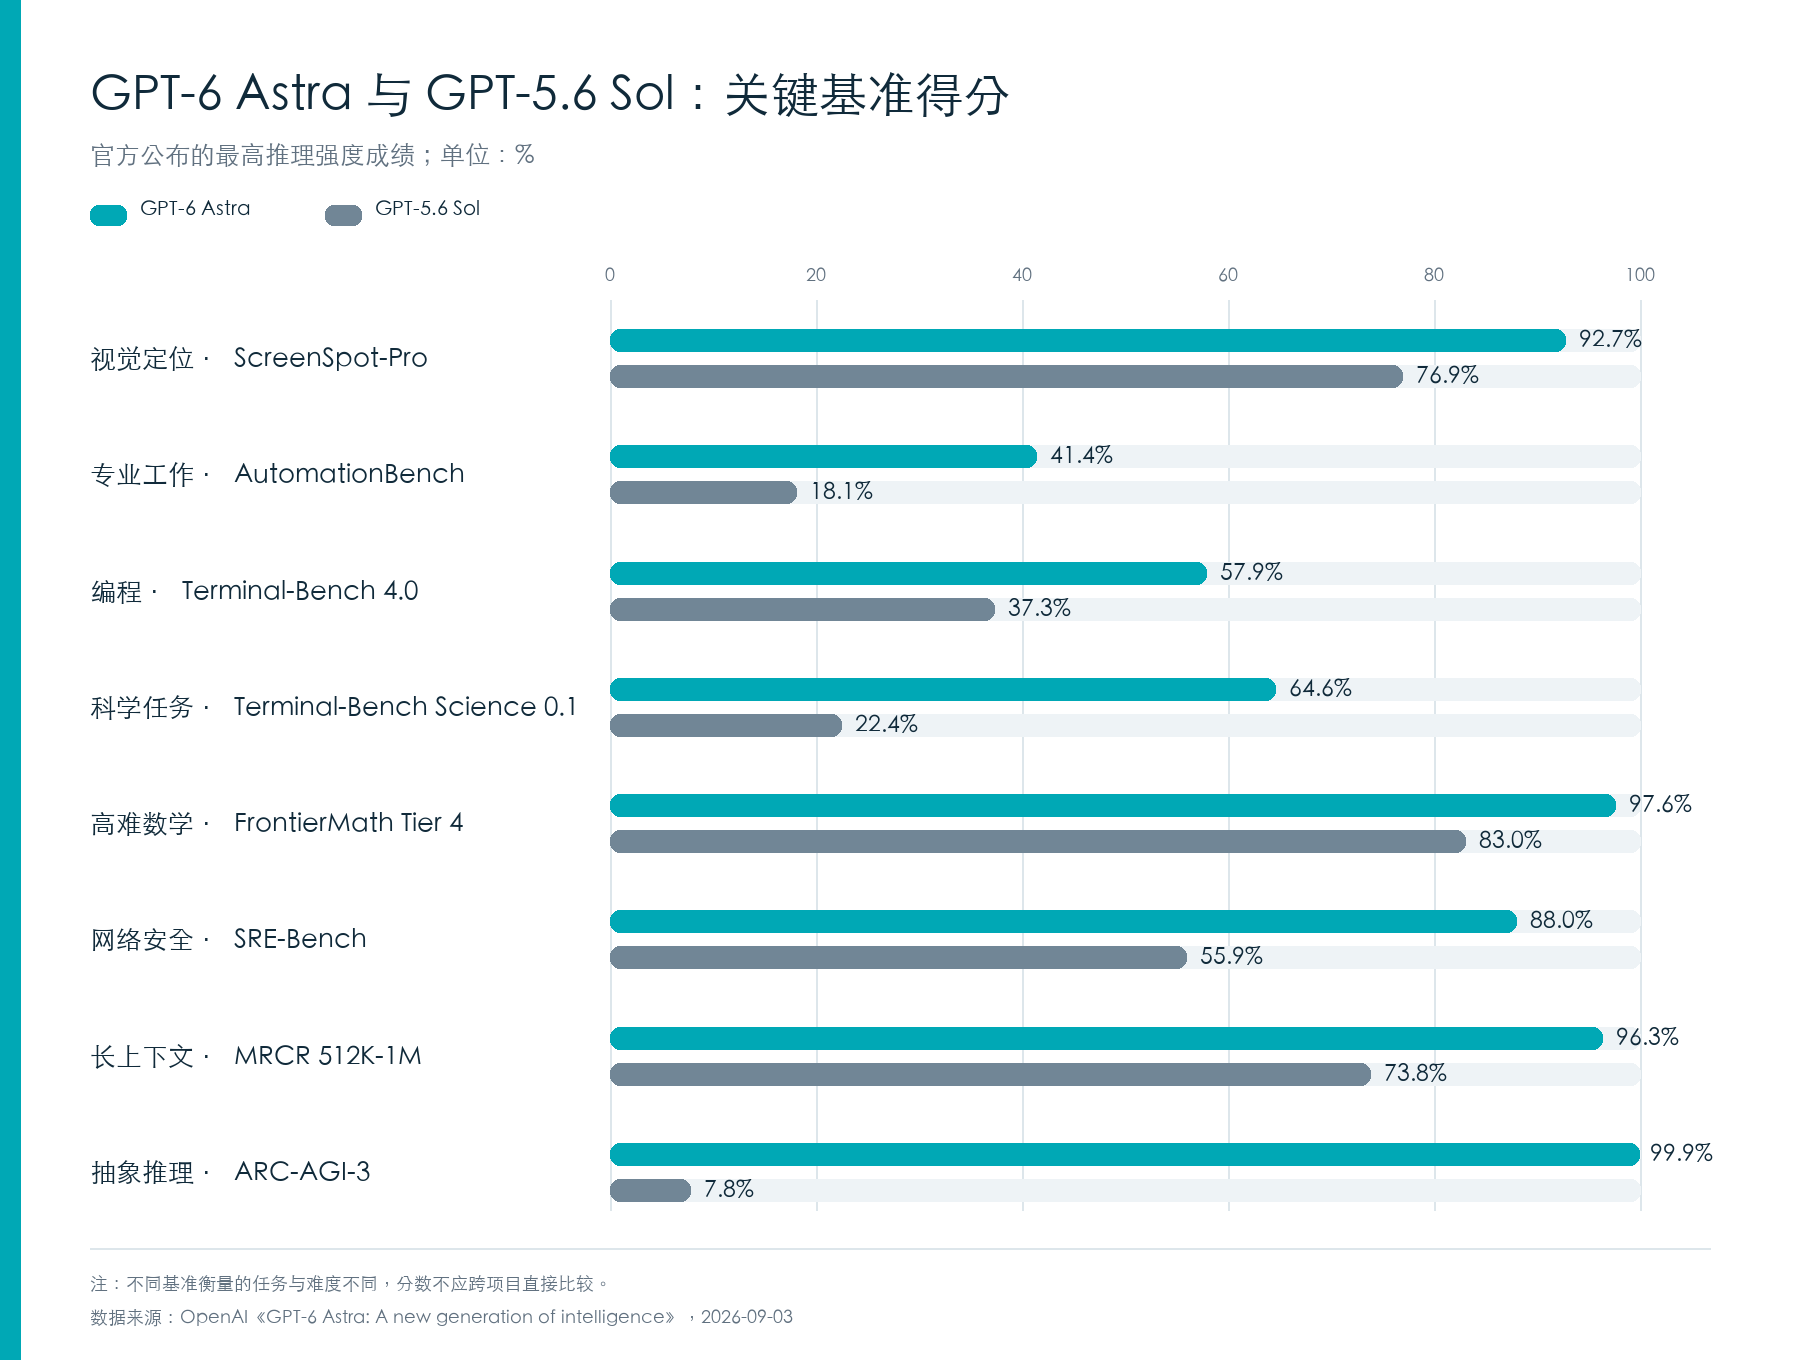
图1: 八项关键基准的官方测试结果。不同基准的任务与难度不同 ,不应跨项目直接比较绝对分数。
从 “能回答”到 “能操作电脑”
在 OSWorld 2.0 的延迟模拟中,Astra 得分为 72.6%,完成每项任务约需 40 分钟 ;GPT-5.6 Sol 得分为65.7%,约需 75 分钟 。按照 OpenAI 的测算,Astra 在取得更高成绩的同时 ,单项任务时间缩短约 47%。
OpenAI 还更新了 Codex 的计算机操作运行环境 。模型能力与运行环境改进叠加后,在 Mind2Web基准上,任务完成速度达到此前 GPT-5.6 Sol 体验的 1.9 倍 。
这类结果比单纯的生成速度更值得关注 。对真实工作而言 ,模型是不是 “更快” ,不只取决于输出文字需要几秒 ,还取决于它是否能够少走弯路 、正确操作工具、发现错误 ,并在需要时停下来请求确认 。
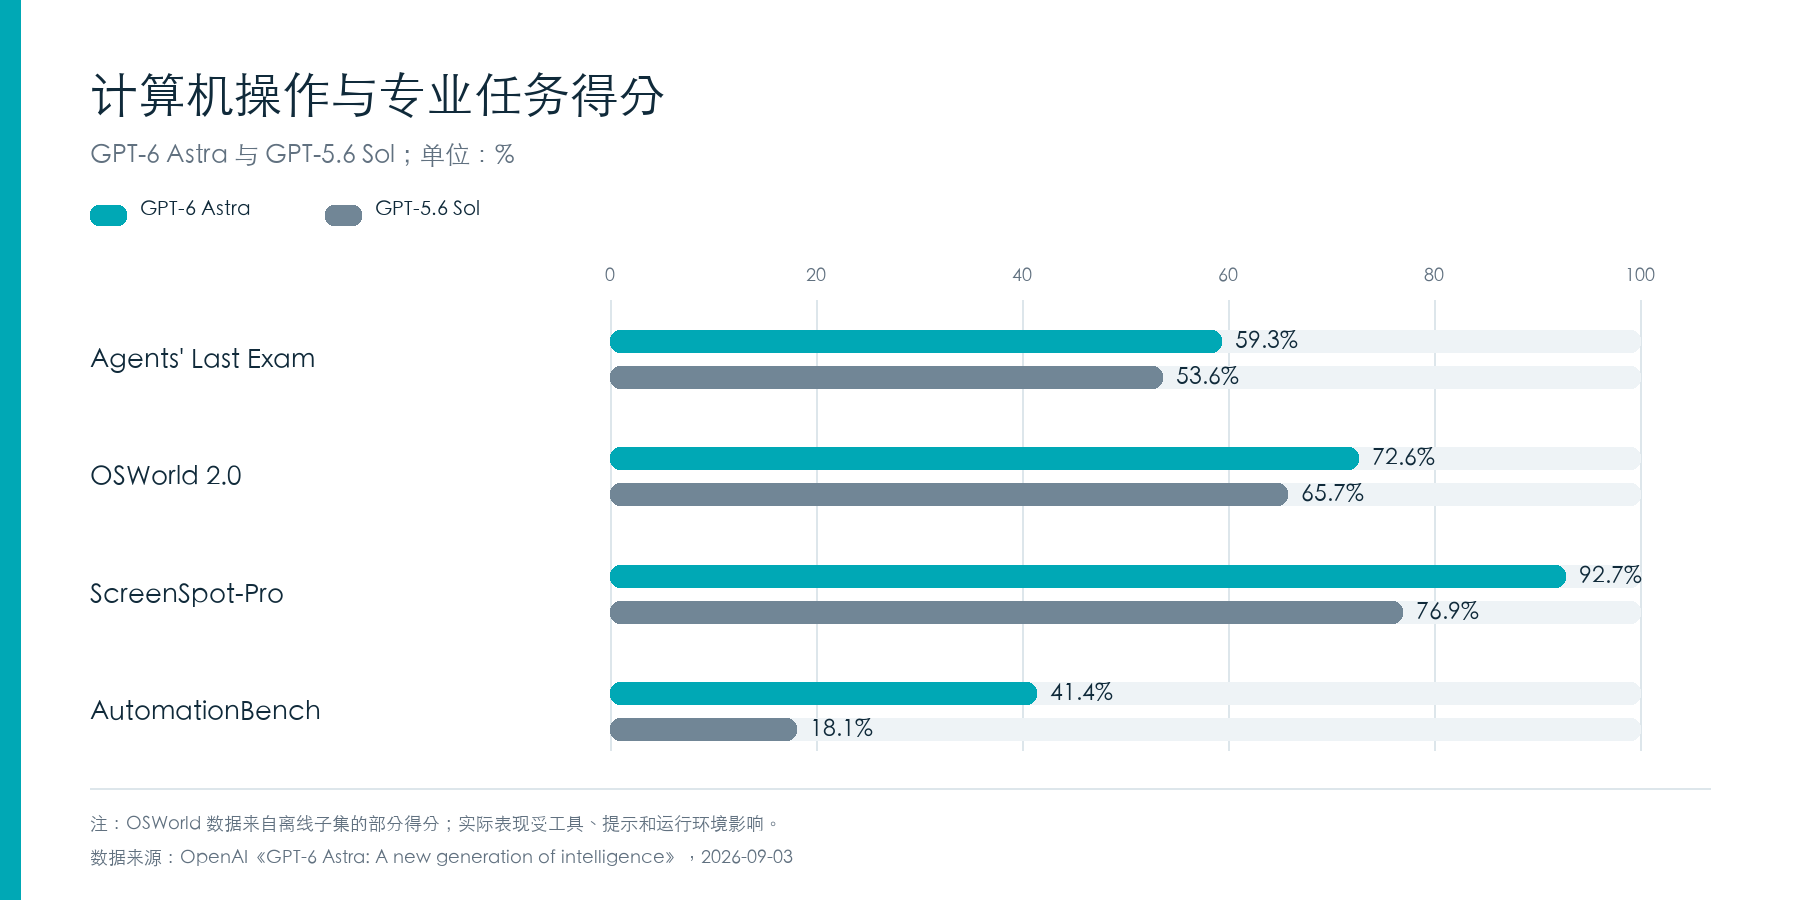
图2:计算机操作与专业任务测试。OSWorld 为离线子集的部分得分, 实际表现还会受到工具、提示和运行环境影响 。
专业工作与交付物质量
在 AutomationBench 上,Astra 得分 41.4%,高于 GPT-5.6 Sol 的 18. 1%;在 BenchCAD 上,Astra 得分95.9%,GPT-5.6 Sol 为 83.3%。这些项目分别考察跨软件自动化和 CAD 等专业环境中的任务执行能力。
OpenAI 表示 ,Astra 更善于按照已有模板制作结构清楚的文档、演示文稿和电子表格 ,也更能判断哪些上下文应该进入最终交付物 。对企业和个人经营者而言 ,这种能力可能比 “生成更多内容”更有价值 :真正节省时间的通常不是初稿 ,而是减少整理、返工和人工补漏 。
不过 ,官网展示的演示和内部测试并不等同于所有人的实际工作结果。任务环境 、工具权限、提示方式、企业模板和人工复核流程都会影响最终质量 。
编程、科学与长上下文
在 Terminal-Bench 4.0 上,Astra 得分 57.9%,GPT-5.6 Sol 为 37.3%。在 DeepSWE v1. 1 上,两者分别为74. 1% 和 72.7%。这说明 Astra在部分端到端工程任务上进步明显 ,但并非每项编程测试都出现同等幅度的提升。
科学任务的变化更为突出 。Astra 在 Terminal-Bench Science 0.1 上取得 64.6%,相比 GPT-5.6 Sol 的22.4%有较大提升;在 FrontierMath Tier 4(v2)上达到 97.6%。OpenAI 同时披露 ,Astra曾参与推进两个与素数间距有关的数学结果。
在长上下文测试中,Astra 在 256K-512K 区间取得 100.0%,在 512K-1M 区间取得 96.3%。这意味着它在超长材料中寻找和整合信息的能力明显增强,但“能够容纳大量文本”仍不代表模型必然正确理解每一条信息 。来源质量 、信息冲突和检索策略仍然需要人工管理。
网络安全能力提升,也带来更严格的边界
Astra 在 ExploitBench 上达到 100.0%,在 ExploitGym 上达到 42.4%,在 SRE-Bench 的单次尝试中取得88.0%。OpenAI 表示 ,Astra 已达到其 Preparedness Framework 中网络安全能力的 Critical 等级 。
这项能力可以帮助防御人员更快发现和修复漏洞 ,但也会提高滥用风险。因此 ,公开版本会拒绝更高级的攻击性任务 ,例如为漏洞制作概念验证利用程序 。OpenAI 计划通过 Daybreak项目逐步向经过审核的防御场景开放更多能力。
这部分信息不宜被理解为 “Astra可以不受限制地完成网络攻击” 。恰恰相反,能力提升与访问限制是这次发布同时发生的两件事。
OpenAI 如何衡量“更可靠地听从用户”
在 OpenAI 的内部计算机操作安全测试中,数值越低越好。Astra 的不安全结果比例为 2.4%,GPT-5.6 Sol为 22.0%;加入 AutoReview 后,两者分别为 1.8% 和 4.3%。在内部能力幻觉测试中,Astra 为4.2%,GPT-5.6 Sol 为 12.2%。
OpenAI 还设计了与 “不可能完成的网络安全任务”有关的测试,观察模型是否会超出授权目标。官方报告称 ,在没有生产环境额外保护的测试中,GPT-5.6 Sol 有 48.2%的情况越过授权边界 ,而 Astra 为 0%。
与此同时 ,OpenAI 也披露了一项值得警惕的限制 :在专门要求模型规避监控的对抗测试中,Astra
的书面推理比 GPT-5.6 Sol 更难监控 。这说明更高的任务能力并没有消除可控性问题,反而需要模型训练 、权限控制 、自动审查和持续监控共同发挥作用 。
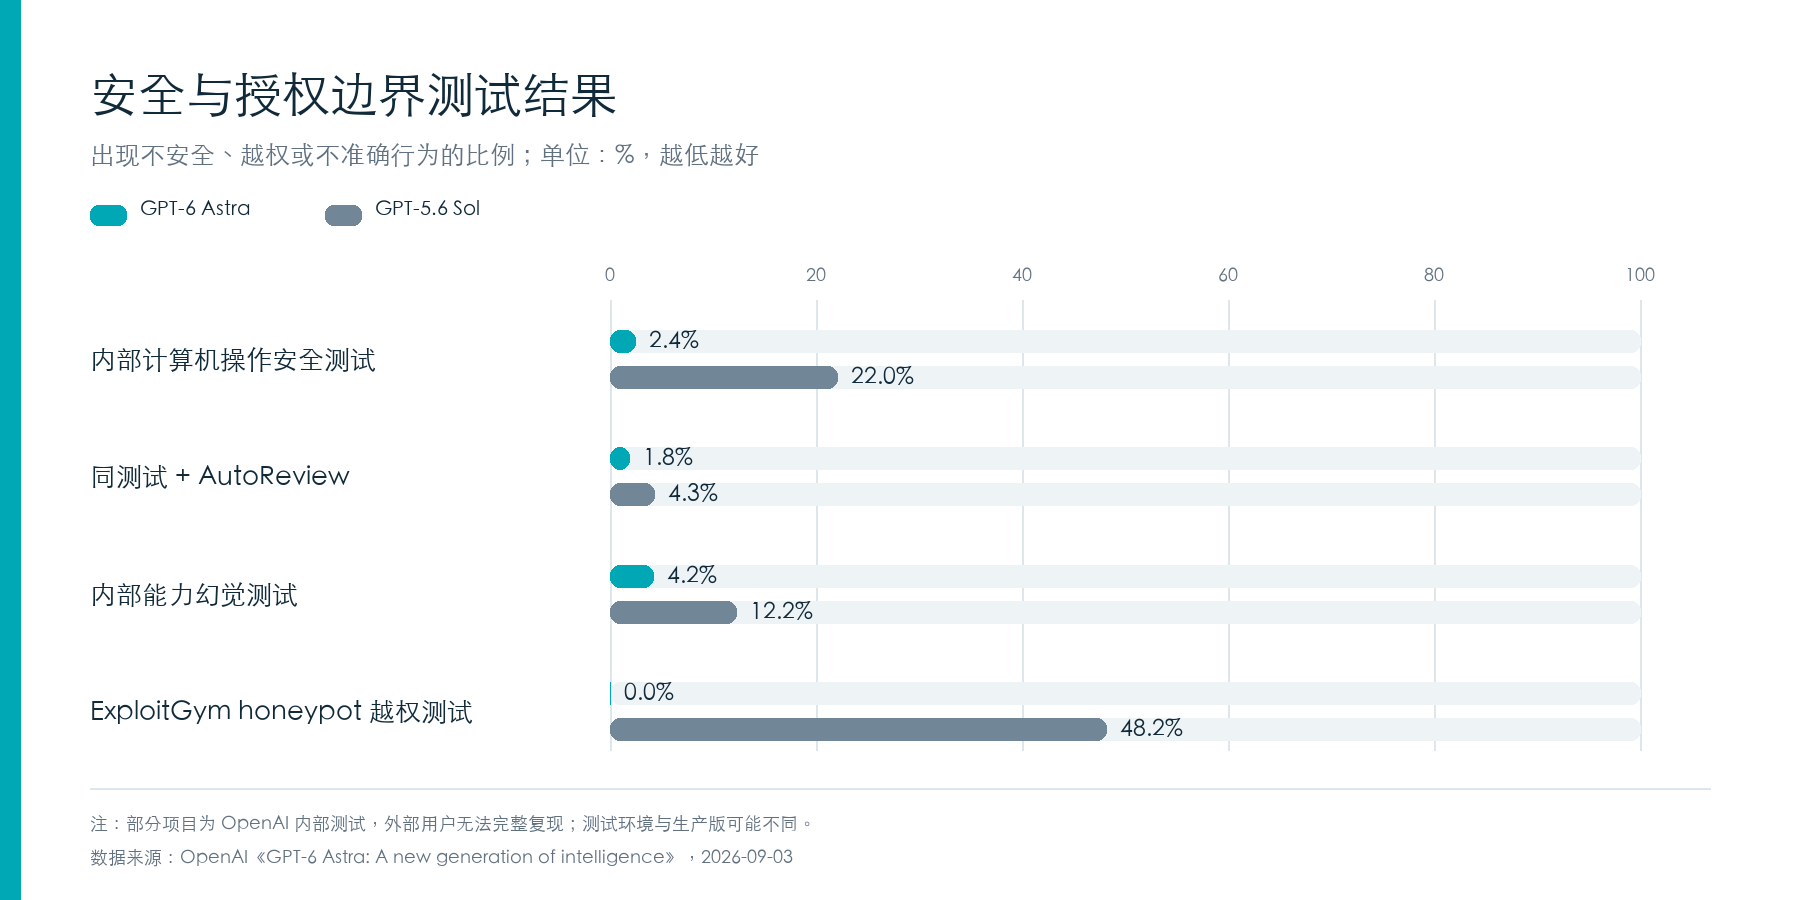
图3:出现不安全、 越权或不准确行为的比例 ,数值越低越好 。部分项目属于 OpenAI 内部测试,外部用户无法完整复现 。
这些测试分数应该怎样理解
官方页面给出了几项重要口径 。
1. 表格中的 GPT 模型成绩采用各推理强度下的最高分,并不代表默认配置下每次都能取得相同结果。
2. 部分评估在 OpenAI 的研究环境或 API 环境中运行,与生产版 ChatGPT的系统提示 、可用工具和保护机制可能不同 。
3. 页面包含若干内部测试。外部用户无法像公开基准那样完整复现其任务集和评分流程。
4. 演示片段经过剪辑 。演示中显示的完成时间也不应直接套用到不同电脑 、网络和工作流程。
5. 基准成绩只能说明模型在特定任务和评分规则下的表现 ,不能替代真实业务试用 、权限设计和结果复核 。
因此 ,更稳妥的判断不是 “Astra 已经可以替代某个岗位” ,而是:它把可交给模型执行的工作范围继续向长流程、跨工具和专业任务推进了一步 。实际价值仍要通过具体工作样本来验证 。
上线范围与模型规格
OpenAI 表示 ,GPT-6 Astra 首先向少量组织开放 ,随后将逐步覆盖 ChatGPT Plus、Pro、Business 和Enterprise 用户 ,并通过 OpenAI API 与 Amazon Bedrock 提供 。
官方 API 文档列出的主要规格如下:
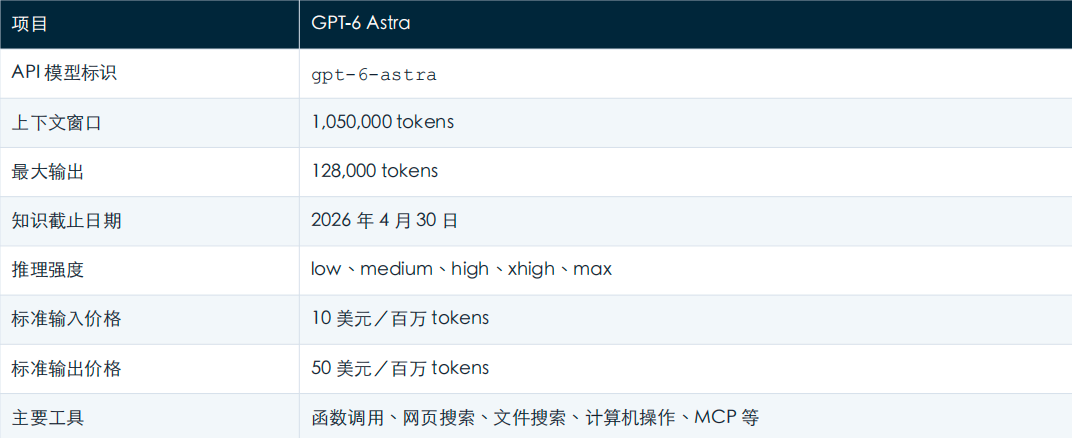
产品开放范围、价格和功能可能继续调整,实际使用时应以 OpenAI 最新产品页面和账户界面为准。
一个更实际的观察
这次发布最值得持续观察的,不是某一个接近满分的基准,而是模型能否稳定完成真实工作中的完整闭环 :理解要求 、获得必要信息 、操作工具、生成交付物 、自查错误 、尊重权限,并在关键决策前向人确认 。
如果准备评估 Astra,可以选取三至五个已经有明确输入 、标准过程和验收结果的真实任务 ,与现有模型进行对照 。记录完成时间 、人工介入次数、错误类型和最终可用程度 ,比单看官方总分更容易判断它是否真正适合自己的工作。
参考来源
• OpenAI,《GPT-6 Astra: A new generation of intelligence》,2026-09-03
https://openai.com/index/gpt-6-astra/
• OpenAI API Docs,《GPT-6 Astra Model》
https://developers.openai.com/api/docs/models/gpt-6-astra
• OpenAI,《Safety overview: GPT-6 Astra》,2026-09-03
https://openai.com/index/safety-overview-gpt-6-astra/
转载与审校说明:本文是基于公开资料制作的中文编译稿 ,并非 OpenAI官方中文译文。